
本サイトの記事や画像は、AIが公的資料や複数の報道を基に事実関係を整理・再構成し制作したものです。[続きを表示]特定の報道内容や表現を再利用・要約することを目的としたものではありません。ただし、誤りや不確定な情報が含まれる可能性がありますので、参考の一助としてご覧いただき、実際の判断は公的資料や各出典元の原文をご確認ください。[私たちの取り組み]
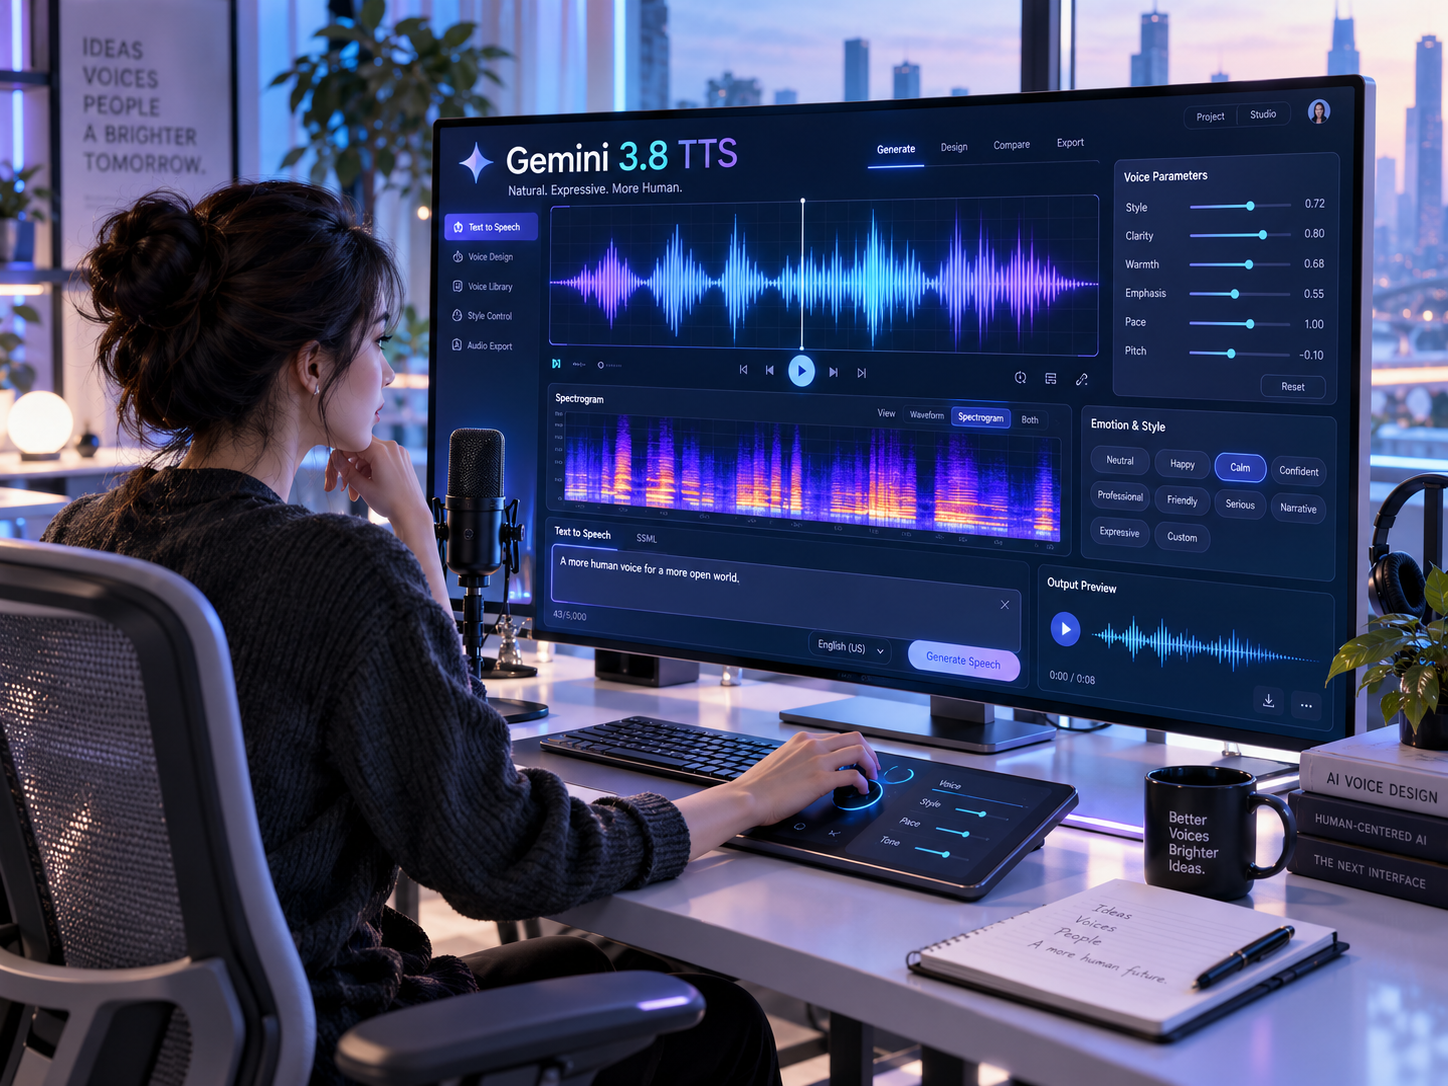
Googleは2026年9月23日付の公式ブログで、テキストを音声に変換する「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表した。自然言語による音声設計や、本人または使用権利を持つ声を短いサンプルから再現する音声複製に対応し、Gemini APIとGoogle AI Studioで提供を始めている。
声の特徴や台詞ごとの演出を指定
Gemini 3.8 Flash TTSは、役割、アクセント、声の特徴を文章で指定し、新しい音声を設計できる。創作向けに音声の忠実度や演技表現を重視したモデルで、Flash-Lite TTSは大量処理や低コスト、低遅延の用途を想定する。
両モデルは台詞ごとの話し方、ペース、感情表現などを制御できる。Googleの公式ブログでは、2,000種類超の本番利用向け音声ライブラリへのアクセスも案内しており、文章で声を設計する方法と既存の音声を選ぶ方法を併用できる。
音声複製には同意確認とSynthID
Googleの開発者向け資料によると、音声複製では本人の声、または使用権利を持つ声について、10~30秒の参照音声から声の特徴を再現できる。作成時には同じ話者による同意音声が必要で、Googleは参照音声と同意音声の話者が一致することを確認する。公式ブログでは、Gemini Audioで生成した音声すべてにSynthID透かしを埋め込むとしている。
Gemini APIのリリースノートでは、両モデルは9月22日付で一般提供(GA)とされている。公式ブログでは、Flash TTSはGemini Notebook、Flash-Lite TTSはGoogle Vidsにも順次展開し、両モデルのGemini Enterprise向けAPIは今後提供する予定としている。
